音声入力アプリを Claude Opus 5.5で作ってみたところ、半日程度で理想のものができた。
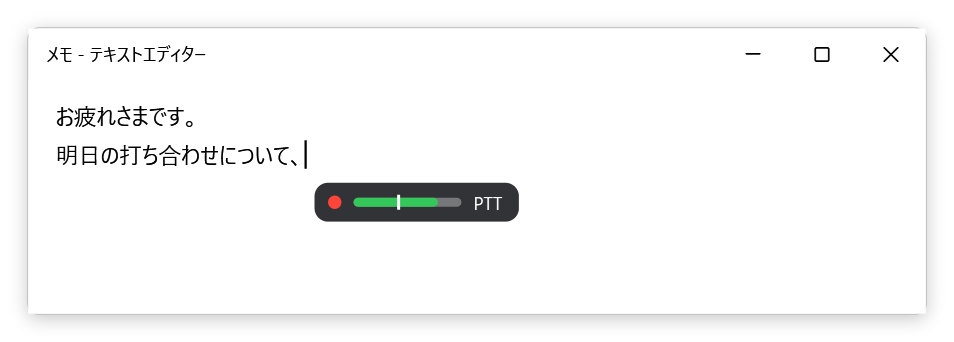
主な機能としては、音声入力と入力後の整形程度のシンプルな作りだが、設定を自分好みにできるのが気に入っている。
※このアプリを作る前にAqua Voiceを久々に試したのだが、自分にとって余計な機能・情報表示が多かったのと、肝心の音声入力や認識結果周りのオプションがほぼ弄れないのが不満だった。
本アプリで特に気に入っているのは、語頭の欠けがなくなったことだ。他の音声入力サービスでは、Bluetooth マイクの起動に時間がかかるせいで喋り始めの数語が認識に渡らずストレスだった。おそらく、声を検出してから、あるいはキーを押してから録音を始める作りなので、最初の部分が抜けてしまうのだと思う。
このアプリでは、マイクを常に開いたままにして、直近 0.3 秒ほどの音声を保持している。キーを押した瞬間に、その直前の音声を録音の先頭に足すので、喋り始めが欠ける問題が解決した。
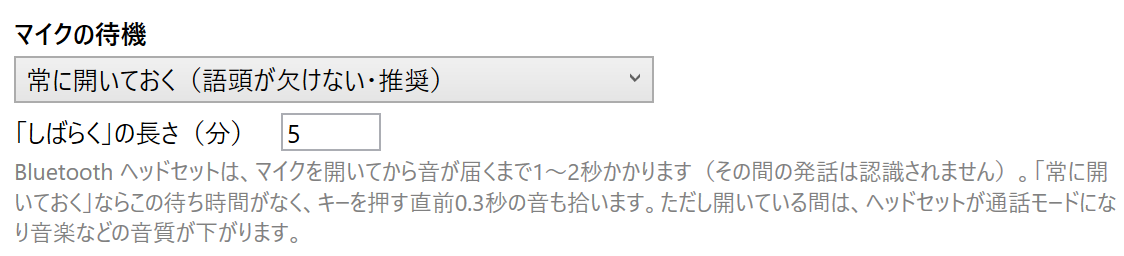
常にマイクを開いておく方式には一応欠点もあって、Bluetooth ヘッドセットはマイクを開いている間ずっと通話モードになるため、音質が下がり、バッテリーの消費も増える。ただ、自分は バッテリ容量が大きめのShokz OpenComm をマイク専用で使っているのであまり影響はなかった。こういう割り切りができるのが自分専用のツールを作る強みだと感じた。
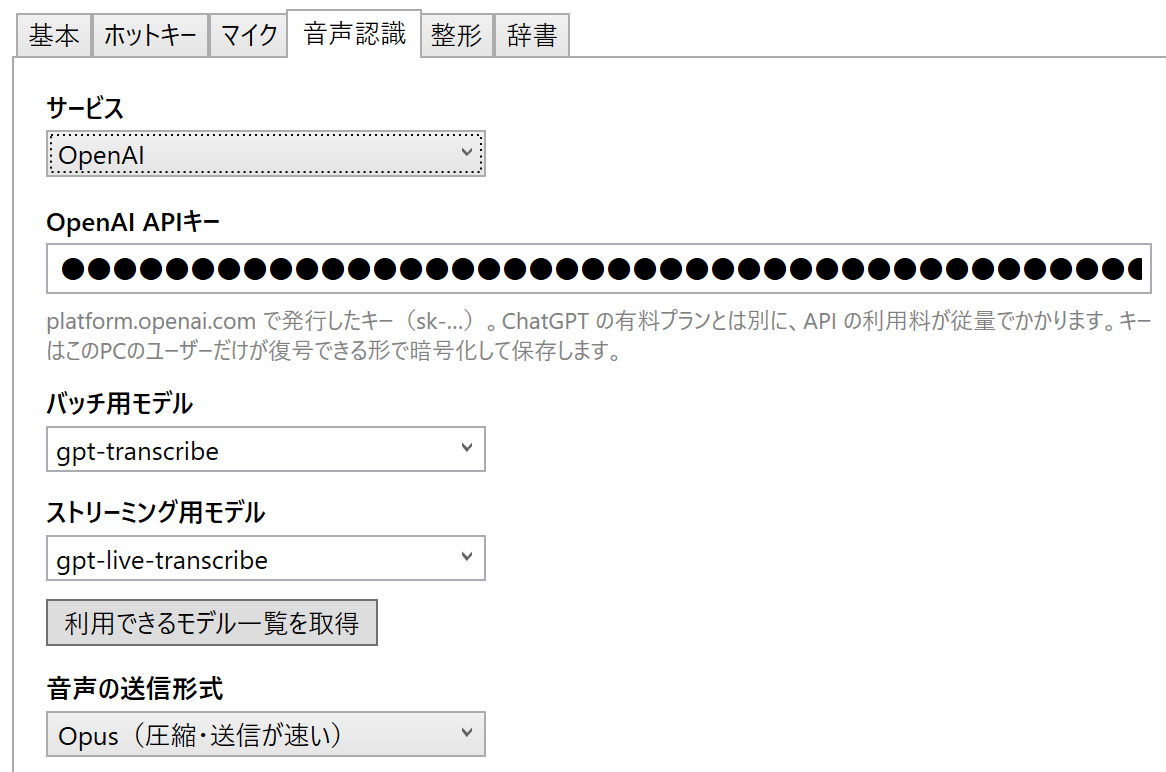
他には、音声認識モデルを自分で選べるメリットがある。今は gpt-transcribe を使っているが、精度がかなり高く満足している。Aqua Voiceのモデルも精度は高い方だとは思うが、修正力が強いというか、一部の用語は喋った通りに認識してくれない時が結構あるように感じた。その点、gpt-transcribeはかなり素直な感じがする。
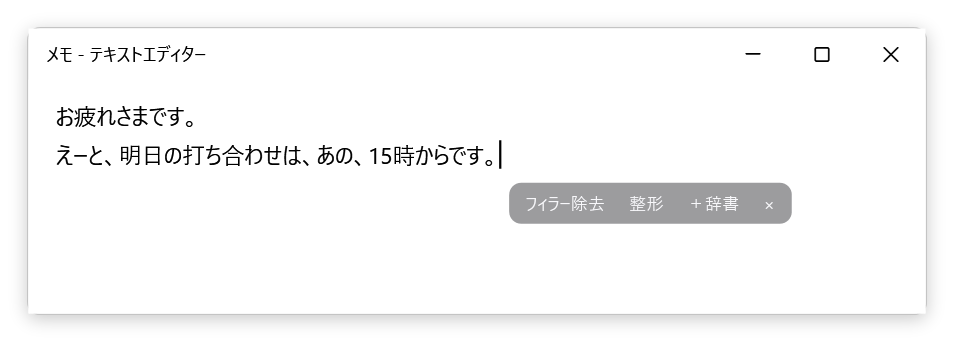
また、認識結果の整形に関しても、有無や、整形対象(フィラーの除去のみか、文章構成まで整理するか)をコントロールできるので使っていてストレスが少ない。
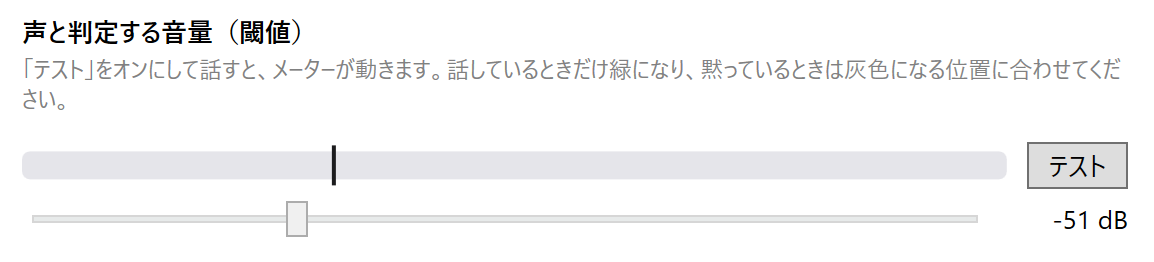
あと、音量の閾値を調整できる点も地味に便利。本アプリではかなり閾値を調整できるので、本当に小声レベルに声量を落としても認識を開始できる(声量が落ちると精度が低くなりやすいが、今のところあまり問題にはなっていない)。
最後に、サブスク系の音声入力サービスを使わずに自作する(もしくはOSSアプリを使う)メリットとしては、使う分だけしか料金を請求されないので、そういう面でもストレスが少ない。私は四六時中喋って入力するわけではなく、キーボードを打つのに疲れてきたときや、ご飯やお菓子を食べているときに音声で入力するタイプ。なので、サブスクだとすごい損をする。私のような頻度なら、API従量課金の方が安く済む。
余談になるが、アプリ開発中のテストで、ChatGPT アプリを起動すると WSL が自動的に立ち上がることに気づいた。最近の ChatGPT アプリは不具合が多いと感じていたが、この挙動でさらに印象が悪くなった。